
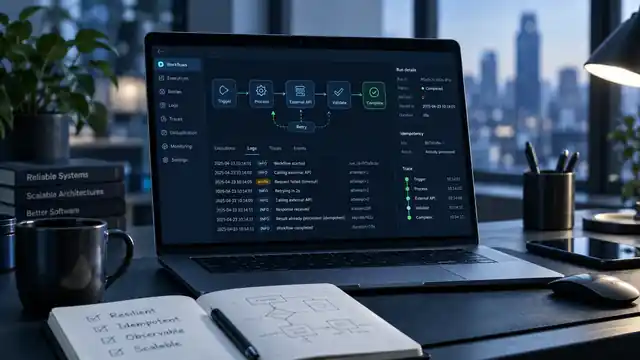
Una automatización no es fiable solo porque funcione en la primera prueba. Los problemas aparecen cuando una API tarda, un webhook llega dos veces, un servicio devuelve un error temporal o un proceso se ejecuta en un orden distinto al esperado.
Diseñar automatizaciones robustas implica asumir que los fallos parciales existen y preparar el flujo para recuperarse sin duplicar acciones, perder información ni dejar al equipo sin saber qué ocurrió.
El error habitual: pensar solo en el camino feliz
Durante una prueba manual, el flujo suele ser simple: entra un dato, se procesa y llega al destino. En producción aparecen situaciones diferentes:
- la API responde con retraso;
- la conexión se corta después de enviar una petición;
- el mismo evento se entrega más de una vez;
- un servicio externo está temporalmente indisponible;
- dos procesos intentan modificar el mismo registro;
- el evento B llega antes que el evento A;
- una acción se completa, pero la siguiente falla.
La calidad de una automatización se mide por cómo responde a estas situaciones, no únicamente por su demostración inicial.
1. Diseña reintentos, pero no reintentes todo
Un error temporal puede resolverse repitiendo una operación unos segundos después. Por eso muchos sistemas aplican reintentos automáticos, normalmente dejando más tiempo entre intentos sucesivos.
El problema aparece cuando se reintenta una operación que ya se ejecutó, pero cuya respuesta se perdió. Si el sistema no puede distinguir entre “no se ejecutó” y “se ejecutó pero no recibí confirmación”, puede crear duplicados.
Por eso los reintentos deben combinarse con una estrategia que permita reconocer la misma operación.
2. La idempotencia evita duplicados
Una operación idempotente puede repetirse sin producir efectos adicionales no deseados. En la práctica, muchas APIs utilizan una clave única para identificar una operación y reconocer que un segundo intento pertenece a la misma solicitud.
Stripe, por ejemplo, documenta el uso de claves de idempotencia para poder repetir peticiones sin crear dos veces el mismo objeto cuando existe una interrupción de red.
El concepto es útil más allá de un proveedor concreto. Si una automatización crea pedidos, contactos, tickets o facturas, conviene disponer de un identificador estable que permita saber si esa acción ya fue procesada.
3. Un webhook puede llegar más de una vez
Los webhooks no deberían diseñarse suponiendo una entrega única. Algunos proveedores reintentan eventos cuando no reciben una respuesta satisfactoria y pueden producirse entregas duplicadas.
Una estrategia habitual consiste en registrar el identificador del evento procesado y comprobarlo antes de ejecutar acciones con efectos permanentes.
Si el evento ya fue procesado, el sistema puede devolver una respuesta correcta sin repetir el trabajo.
4. No dependas del orden de llegada
En sistemas distribuidos, los eventos pueden llegar en un orden diferente al esperado. Stripe documenta expresamente que el orden de entrega de sus eventos no está garantizado.
Esto obliga a diseñar el consumidor para consultar el estado real cuando sea necesario en lugar de confiar únicamente en la secuencia de mensajes.
Por ejemplo, si recibes primero un evento de pago y después otro relacionado con la creación de una suscripción, el flujo no debería fallar solo porque esperaba el orden contrario.
5. Responde rápido y procesa después cuando convenga
Un webhook no debería quedarse esperando mientras se ejecuta un proceso pesado. Cuando la arquitectura lo permite, es preferible validar el evento, registrarlo y devolver una respuesta correcta cuanto antes, dejando el trabajo más complejo para una cola o un proceso asíncrono.
Esto reduce timeouts y evita reintentos provocados simplemente porque el endpoint tardó demasiado en contestar.
6. Separa recepción, validación y ejecución
Un flujo robusto puede dividirse en tres etapas:
- Recepción: aceptar el evento o la petición.
- Validación: comprobar formato, autenticidad, duplicados y datos mínimos.
- Ejecución: realizar las acciones de negocio.
Esta separación hace más fácil detectar dónde ocurrió el problema y repetir solo la parte necesaria.
7. Registra identificadores útiles
Un log debería permitir reconstruir una ejecución. Guardar únicamente “error en integración” aporta poco valor. Resulta más útil registrar:
- identificador de la operación;
- tipo de evento;
- fecha y hora;
- sistema de origen y destino;
- resultado;
- número de intento;
- mensaje de error relevante;
- estado final.
No es necesario registrar datos sensibles que no aporten al diagnóstico. La trazabilidad debe equilibrar utilidad, privacidad y retención.
8. Diferencia errores temporales y permanentes
No todos los errores deben tratarse igual. Una caída temporal, un timeout o una saturación pueden justificar reintentos. Un dato inválido, un permiso denegado o una referencia inexistente normalmente requieren corregir la causa antes de volver a ejecutar.
Reintentar indefinidamente un error permanente solo consume recursos y oculta el problema.
9. Define un estado intermedio
En procesos con varias etapas, puede ser útil registrar estados como pendiente, procesando, completado o error. Así se evita que dos workers ejecuten la misma tarea al mismo tiempo y se puede identificar qué operaciones necesitan intervención.
Este patrón también facilita construir paneles de seguimiento y reanudar procesos sin empezar desde cero.
10. Prepara una cola de errores
Cuando una tarea supera el número razonable de reintentos, debería salir del flujo normal y quedar identificada para revisión. Esa cola evita que un único registro defectuoso bloquee el resto del proceso.
Además permite diferenciar entre automatizaciones sanas con algunos casos excepcionales y procesos completamente rotos.
11. Añade alertas que indiquen contexto
Una alerta útil no debería limitarse a “la automatización ha fallado”. Conviene que indique qué integración, qué operación, cuántos intentos y cuál es el siguiente paso posible.
También hay que evitar el exceso de avisos. Si cada error temporal genera una notificación, el equipo terminará ignorándolas.
12. Diseña la recuperación antes de necesitarla
Antes de poner un flujo en producción conviene saber cómo recuperar una operación fallida:
- ¿puede repetirse de forma segura?
- ¿cómo se identifica el registro original?
- ¿qué ocurre si una parte ya se completó?
- ¿existe una forma de marcarla como procesada?
- ¿quién recibe la alerta?
- ¿qué información necesita para actuar?
Responder estas preguntas durante el diseño evita improvisar cuando ya existe impacto real.
Ejemplo: formulario que crea un contacto y envía una notificación
Imagina un formulario de WordPress que crea un contacto en un CRM y después envía una notificación interna. El CRM acepta el contacto, pero la conexión se corta antes de devolver respuesta.
Si el flujo reintenta sin control, puede crear el contacto dos veces. Si utiliza un identificador único para la operación, puede comprobar que el contacto ya existe y continuar con la siguiente etapa.
Después, si el envío de la notificación falla, no debería volver a crear el contacto: debería repetir únicamente la parte pendiente.
Checklist de una automatización preparada para producción
- cada operación tiene un identificador trazable;
- los reintentos están limitados;
- las acciones con efectos permanentes pueden detectar duplicados;
- el flujo no depende ciegamente del orden de eventos;
- los webhooks responden con rapidez;
- los errores temporales y permanentes se tratan de forma distinta;
- existe registro de estado;
- los fallos repetidos salen a una cola de revisión;
- las alertas incluyen contexto;
- existe un procedimiento de recuperación.
Automatizar no es solo conectar herramientas
Una integración profesional debe seguir funcionando cuando aparecen retrasos, duplicados y fallos parciales. Esa diferencia separa una demostración funcional de un proceso que puede utilizarse de forma continua en un negocio.
El servicio de automatización e integraciones parte de esta idea: entender el proceso, reducir trabajo manual y mantener control sobre errores, datos y dependencias. También puedes consultar la guía sobre webhooks y APIs en WordPress para ver cómo encajan estas piezas en una arquitectura más sencilla.